
Как ускорить веб-сервис: причины медленной работы и способы оптимизации
 Оптимизация веб-сервиса: поиск причин медленной скорости загрузки в профайлере
Если веб-сервис тормозит, в девяти случаях из десяти виноваты не «слабый сервер» и не «плохой фреймворк», а конкретные пять-семь мест в коде и базе данных. Оптимизация веб-сервиса начинается не с покупки железа, а с замеров: нужно понять, где именно уходят секунды. Типовая работа по ускорению занимает от 20 до 100 часов и стоит примерно от 60 до 300 тысяч рублей, причём первые заметные результаты — сокращение времени ответа в два-три раза — обычно достигаются за первые 5 часов.
Дальше разберём по порядку: как измерить скорость загрузки честно, какие причины медленной работы встречаются чаще всего, что делать с базой, бэкендом и фронтендом, и когда проще переписать модуль, чем чинить.
Дальше разберём по порядку: как измерить скорость загрузки честно, какие причины медленной работы встречаются чаще всего, что делать с базой, бэкендом и фронтендом, и когда проще переписать модуль, чем чинить.
Что считать медленным: нормальные цифры производительности веб-приложения
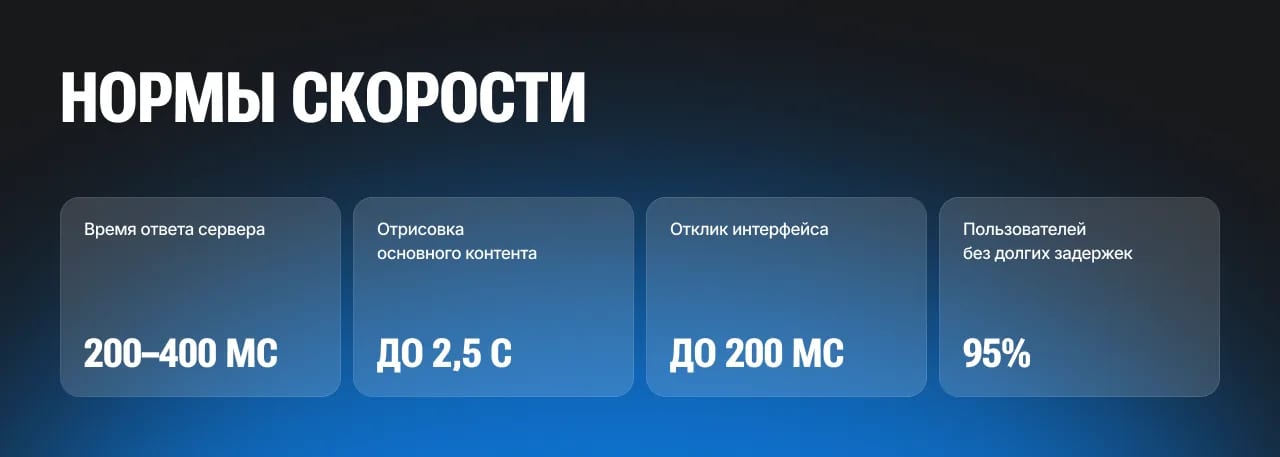
Прежде чем что-то ускорять, стоит договориться о целевых значениях, иначе оптимизация превращается в бесконечный процесс. Для пользовательских страниц ориентир такой: сервер отдаёт ответ за 200–400 мс, первая отрисовка контента (LCP) укладывается в 2,5 секунды на 4G, а взаимодействие с интерфейсом отвечает быстрее 200 мс. Для внутренних порталов и личных кабинетов допустимо чуть больше, но не в разы.
Важнее среднего значения — 95-й процентиль. Средний ответ в 300 мс при 95-м процентиле в 6 секунд означает, что каждый двадцатый ваш клиент сидит и смотрит на спиннер. Именно эти пользователи пишут в поддержку и уходят. Поэтому производительность веб-приложения всегда измеряют по «хвостам» распределения, а не по красивой середине.
Ещё один ориентир — деньги. По нашим замерам на B2B-порталах ускорение страницы каталога с 4,5 до 1,2 секунды давало рост числа оформленных заказов на 8–14% при том же трафике. Прежде чем вкладываться в ускорение, посчитайте потенциальный эффект — мы разбирали методику в статье про ROI сайта и приложения.
Важнее среднего значения — 95-й процентиль. Средний ответ в 300 мс при 95-м процентиле в 6 секунд означает, что каждый двадцатый ваш клиент сидит и смотрит на спиннер. Именно эти пользователи пишут в поддержку и уходят. Поэтому производительность веб-приложения всегда измеряют по «хвостам» распределения, а не по красивой середине.
Ещё один ориентир — деньги. По нашим замерам на B2B-порталах ускорение страницы каталога с 4,5 до 1,2 секунды давало рост числа оформленных заказов на 8–14% при том же трафике. Прежде чем вкладываться в ускорение, посчитайте потенциальный эффект — мы разбирали методику в статье про ROI сайта и приложения.
Как найти узкое место, а не гадать
Самая дорогая ошибка — начинать оптимизацию с догадок. Команда переписывает фронтенд, ставит Redis, меняет хостинг, а страница по-прежнему грузится четыре секунды, потому что виноват один невинный запрос в цикле. Поэтому первым шагом всегда идут замеры, и они занимают не больше двух-трёх дней.
Минимальный набор инструментов выглядит так. На бэкенде — APM или профайлер уровня Sentry Performance, New Relic, Blackfire, py-spy: он показывает распределение времени по функциям и запросам. На базе — журнал медленных запросов и EXPLAIN ANALYZE по каждому подозреваемому. На фронтенде — вкладка Performance в Chrome DevTools и Lighthouse, но обязательно вместе с полевыми данными от реальных пользователей, потому что на вашем ноутбуке с гигабитным интернетом всё летает.
Минимальный набор инструментов выглядит так. На бэкенде — APM или профайлер уровня Sentry Performance, New Relic, Blackfire, py-spy: он показывает распределение времени по функциям и запросам. На базе — журнал медленных запросов и EXPLAIN ANALYZE по каждому подозреваемому. На фронтенде — вкладка Performance в Chrome DevTools и Lighthouse, но обязательно вместе с полевыми данными от реальных пользователей, потому что на вашем ноутбуке с гигабитным интернетом всё летает.
Почему веб-сервис работает медленно: семь типовых причин
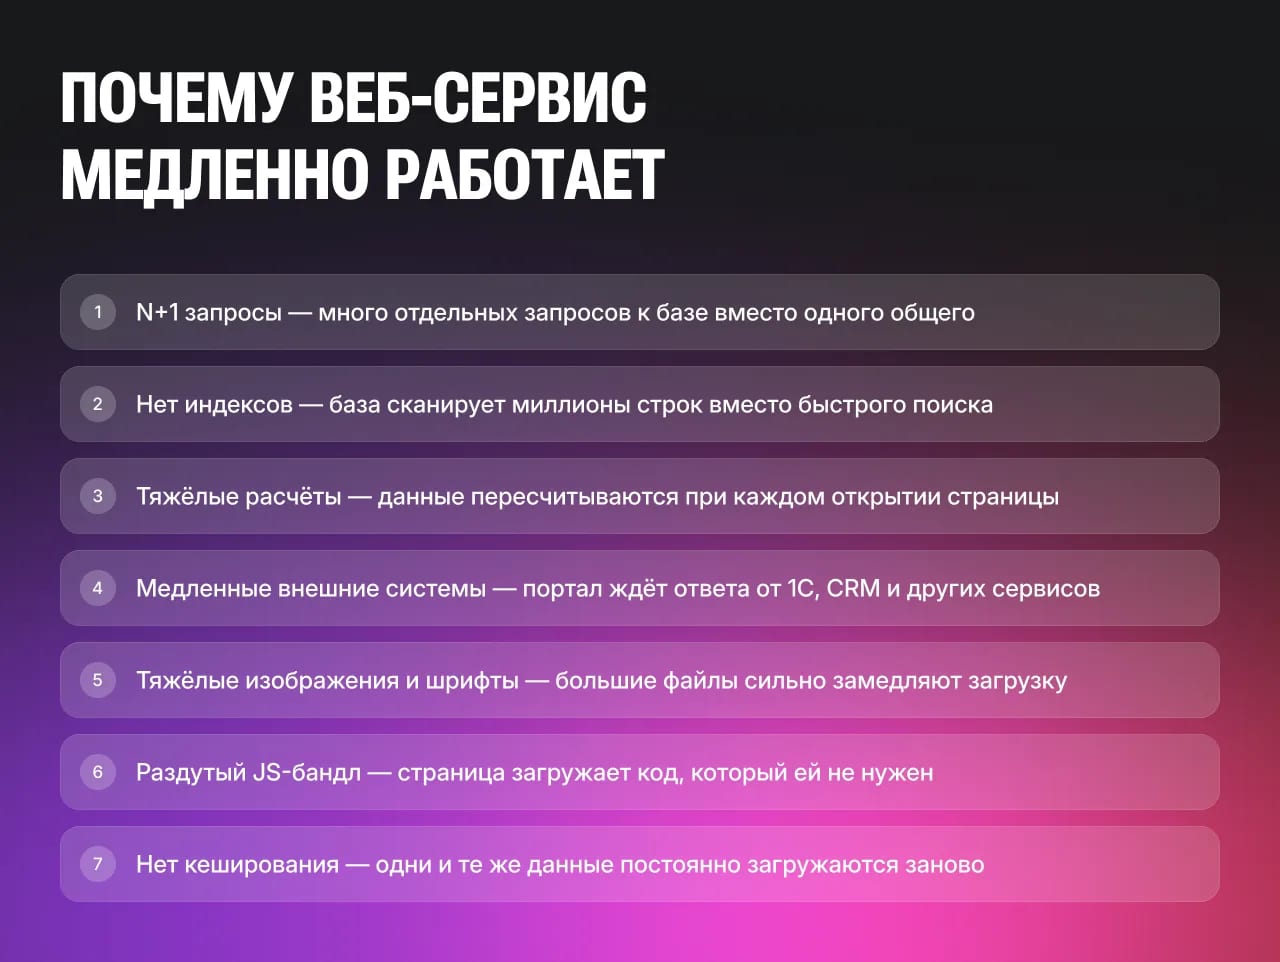
Первая и самая частая — проблема N+1. Код получает список из 50 заказов, а затем для каждого отдельным запросом тянет клиента, менеджера и статус. Вместо одного запроса база получает 151, каждый по 3 мс, и страница честно висит полсекунды на одном только сборе данных. Лечится жадной загрузкой связей или явными JOIN.
Вторая — отсутствие индексов. Таблица разрослась с 20 тысяч строк до двух миллионов, и запрос, который раньше выполнялся за 5 мс, теперь сканирует всё подряд.
Третья — тяжёлые агрегации на лету: остатки, взаиморасчёты, суммы по контрагенту считаются при каждом открытии страницы, хотя меняются раз в час.
Четвёртая причина — синхронные обращения к внешним системам. Портал при загрузке страницы дергает 1С или CRM, ждёт ответа, а тот приходит за две секунды или не приходит вовсе.
Пятая — неоптимизированные картинки и шрифты: три баннера по 2 МБ в PNG убивают скорость загрузки надёжнее любого кривого SQL.
Шестая — раздутый JS-бандл, когда на страницу входа тянется вся библиотека графиков.
Седьмая — отсутствие кеширования хоть на каком-нибудь уровне.
Отдельно упомянем причину, которую редко считают технической: архитектура, заложенная под другую нагрузку. Сервис проектировался на сотню пользователей, а работает на десять тысяч, и никакие точечные правки его не спасут. О том, как закладывать запас прочности с самого начала, мы подробно писали в материале про архитектуру и этапы создания веб-сервиса.
Вторая — отсутствие индексов. Таблица разрослась с 20 тысяч строк до двух миллионов, и запрос, который раньше выполнялся за 5 мс, теперь сканирует всё подряд.
Третья — тяжёлые агрегации на лету: остатки, взаиморасчёты, суммы по контрагенту считаются при каждом открытии страницы, хотя меняются раз в час.
Четвёртая причина — синхронные обращения к внешним системам. Портал при загрузке страницы дергает 1С или CRM, ждёт ответа, а тот приходит за две секунды или не приходит вовсе.
Пятая — неоптимизированные картинки и шрифты: три баннера по 2 МБ в PNG убивают скорость загрузки надёжнее любого кривого SQL.
Шестая — раздутый JS-бандл, когда на страницу входа тянется вся библиотека графиков.
Седьмая — отсутствие кеширования хоть на каком-нибудь уровне.
Отдельно упомянем причину, которую редко считают технической: архитектура, заложенная под другую нагрузку. Сервис проектировался на сотню пользователей, а работает на десять тысяч, и никакие точечные правки его не спасут. О том, как закладывать запас прочности с самого начала, мы подробно писали в материале про архитектуру и этапы создания веб-сервиса.
Что делать с базой данных: самый быстрый выигрыш
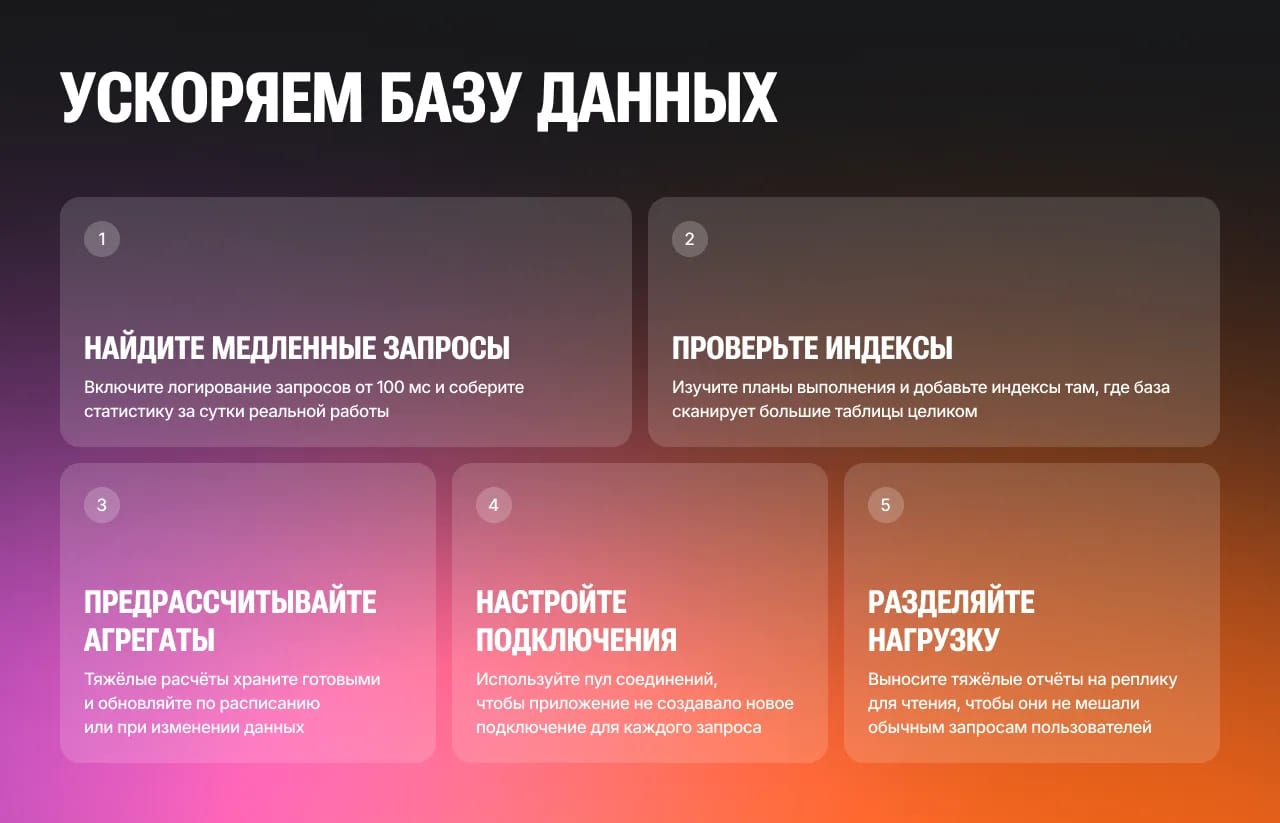
База — место, где обычно лежит от половины до двух третей всего потерянного времени, и одновременно место, где правки дают самый быстрый эффект. Начинать нужно с журнала медленных запросов: включаете логирование всего, что дольше 100 мс, собираете данные за сутки реальной работы и группируете по шаблону запроса.
Дальше по каждому запросу смотрите план выполнения. Seq Scan по большой таблице — почти всегда пропущенный индекс. Составные индексы стройте по порядку селективности: сначала колонка, которая сильнее сужает выборку. Не плодите индексы бесконечно — каждый замедляет вставку и обновление, и на таблице с активной записью пять лишних индексов дадут обратный эффект.
Агрегаты, которые считаются тяжело и меняются редко, выносите в отдельные таблицы или материализованные представления с обновлением по расписанию либо по событию. На одном из порталов расчёт доступных остатков по 40 тысячам товаров занимал 2,8 секунды на каждое открытие каталога; после переноса в предрассчитанную таблицу с обновлением раз в пять минут страница стала отдаваться за 180 мс. Бизнес-требование «остатки в реальном времени» на практике почти всегда означает «не старше нескольких минут».
Не забывайте про базовую гигиену: пулы соединений, чтобы приложение не открывало новое подключение на каждый запрос, регулярный VACUUM и ANALYZE в PostgreSQL, реплика для чтения, если отчёты мешают работе пользователей.
Дальше по каждому запросу смотрите план выполнения. Seq Scan по большой таблице — почти всегда пропущенный индекс. Составные индексы стройте по порядку селективности: сначала колонка, которая сильнее сужает выборку. Не плодите индексы бесконечно — каждый замедляет вставку и обновление, и на таблице с активной записью пять лишних индексов дадут обратный эффект.
Агрегаты, которые считаются тяжело и меняются редко, выносите в отдельные таблицы или материализованные представления с обновлением по расписанию либо по событию. На одном из порталов расчёт доступных остатков по 40 тысячам товаров занимал 2,8 секунды на каждое открытие каталога; после переноса в предрассчитанную таблицу с обновлением раз в пять минут страница стала отдаваться за 180 мс. Бизнес-требование «остатки в реальном времени» на практике почти всегда означает «не старше нескольких минут».
Не забывайте про базовую гигиену: пулы соединений, чтобы приложение не открывало новое подключение на каждый запрос, регулярный VACUUM и ANALYZE в PostgreSQL, реплика для чтения, если отчёты мешают работе пользователей.
Как ускорить бэкенд: кеширование, очереди и лишняя работа
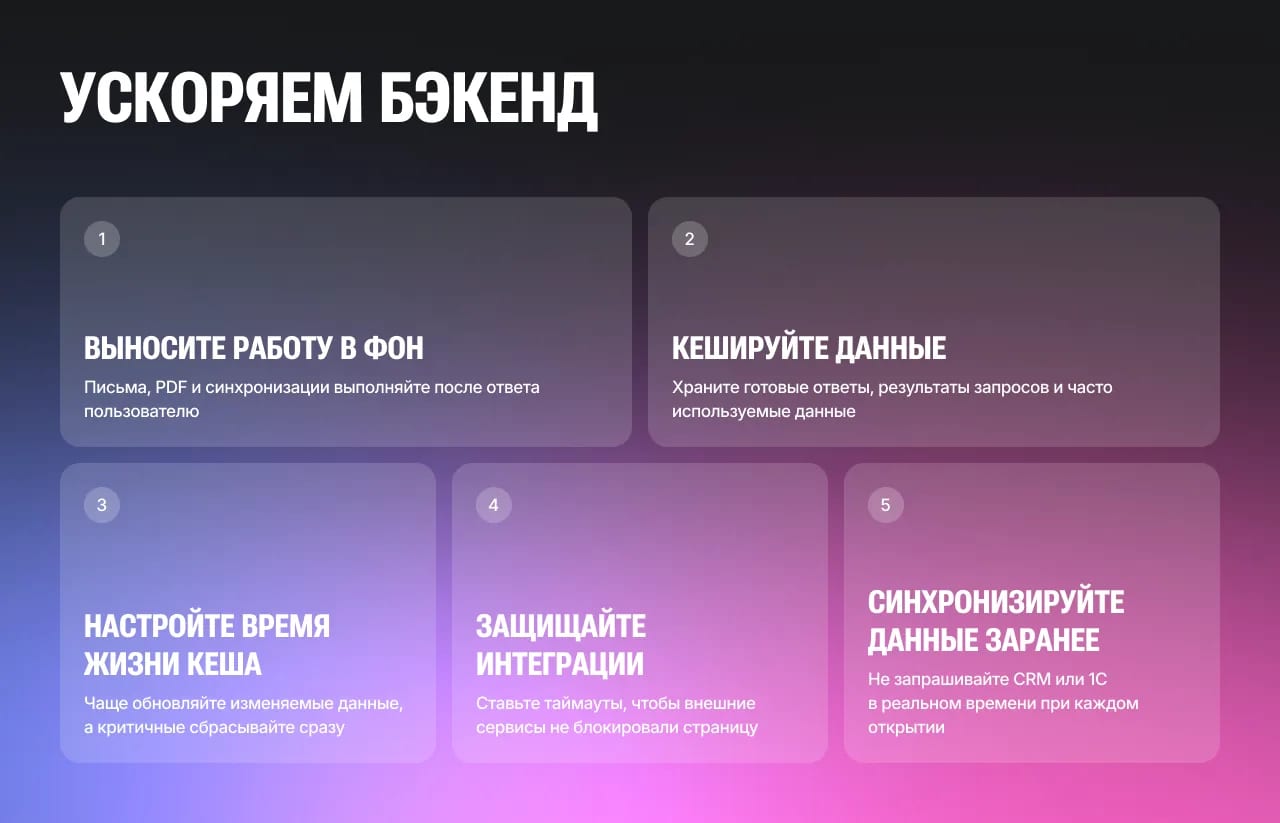
После базы разбираются с логикой приложения. Основной принцип простой: не делать при запросе пользователя того, что можно сделать заранее или потом. Отправка письма, генерация PDF, синхронизация с 1С, пересчёт бонусов — всё это выносится в фоновые очереди, а пользователь получает ответ сразу.
Кеширование стоит выстраивать слоями. Самый верхний — кеш готовых HTTP-ответов для анонимных страниц на уровне Nginx или CDN, он снимает нагрузку почти полностью. Ниже — кеш фрагментов и результатов запросов в Redis: меню, справочники, настройки, права ролей. Совсем внизу — кеш внутри процесса на время одного запроса, чтобы одни и те же данные не запрашивались трижды разными участками кода.
Главная сложность кеширования — не запись, а инвалидация. Чем сложнее ключи, тем чаще пользователь видит устаревшие цены и обижается. Рабочий компромисс: короткий TTL от 30 секунд до пяти минут для часто меняющихся данных плюс явный сброс по событию для критичного, вроде смены цены или статуса заказа.
Отдельная тема — интеграции. Любой внешний вызов оборачивайте таймаутом в одну-две секунды и предохранителем (circuit breaker), чтобы падение чужой системы не превращалось в падение вашей. Если данные из CRM нужны на странице, их лучше периодически синхронизировать к себе, а не запрашивать в реальном времени. Сценарии такой интеграции мы разбирали отдельно.
Кеширование стоит выстраивать слоями. Самый верхний — кеш готовых HTTP-ответов для анонимных страниц на уровне Nginx или CDN, он снимает нагрузку почти полностью. Ниже — кеш фрагментов и результатов запросов в Redis: меню, справочники, настройки, права ролей. Совсем внизу — кеш внутри процесса на время одного запроса, чтобы одни и те же данные не запрашивались трижды разными участками кода.
Главная сложность кеширования — не запись, а инвалидация. Чем сложнее ключи, тем чаще пользователь видит устаревшие цены и обижается. Рабочий компромисс: короткий TTL от 30 секунд до пяти минут для часто меняющихся данных плюс явный сброс по событию для критичного, вроде смены цены или статуса заказа.
Отдельная тема — интеграции. Любой внешний вызов оборачивайте таймаутом в одну-две секунды и предохранителем (circuit breaker), чтобы падение чужой системы не превращалось в падение вашей. Если данные из CRM нужны на странице, их лучше периодически синхронизировать к себе, а не запрашивать в реальном времени. Сценарии такой интеграции мы разбирали отдельно.
Что оптимизировать на фронтенде, чтобы поднять скорость загрузки
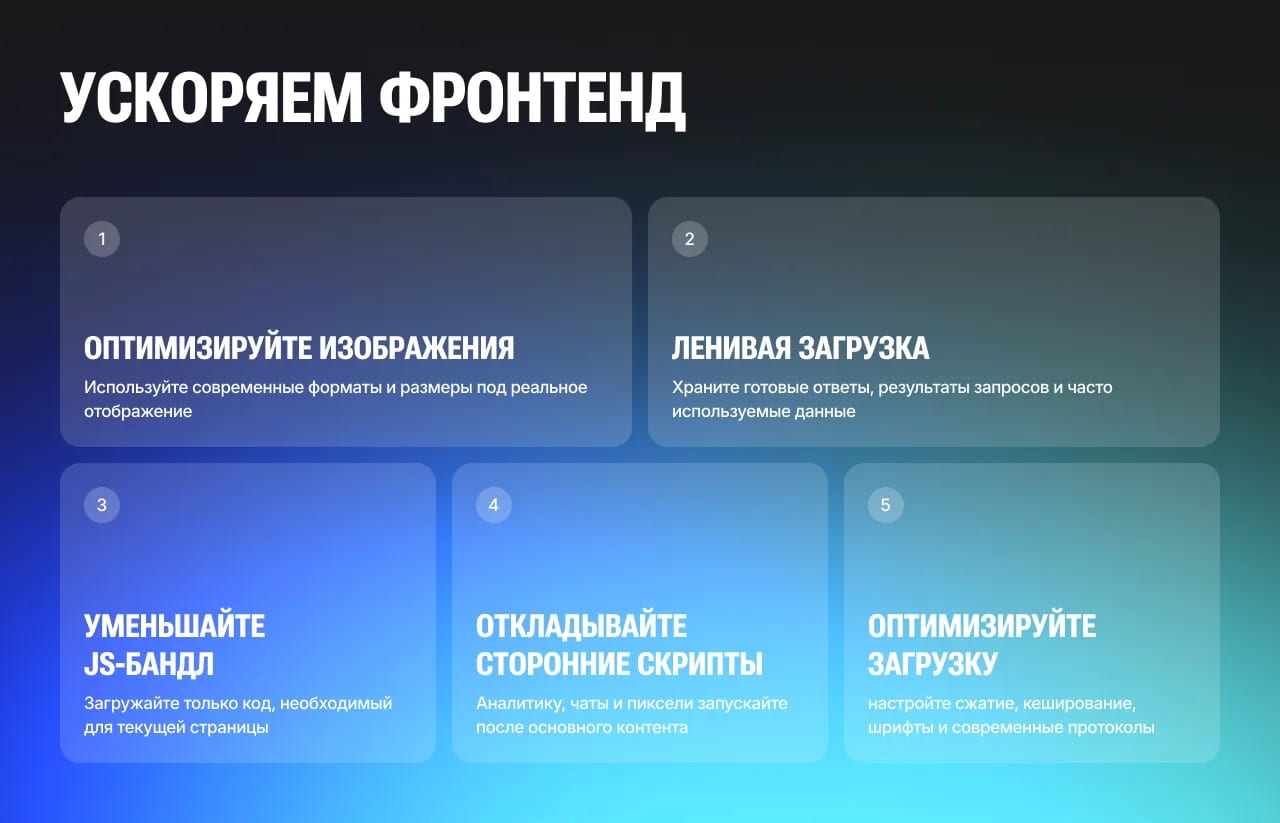
Когда сервер отвечает за 200 мс, а страница всё равно появляется через четыре секунды, дело в браузере. Здесь порядок работ почти всегда один и тот же и почти всегда даёт быстрый результат.
Картинки — первое. Перевод в WebP или AVIF, ресайз под реальные размеры отображения, атрибуты width и height, чтобы не было скачков вёрстки, и ленивая загрузка всего, что ниже первого экрана. На каталоге мебели это единственное изменение сократило вес страницы с 6,2 до 1,4 МБ.
Скрипты — второе. Разделение бандла по маршрутам, чтобы страница входа не тянула код админки, удаление дублирующихся библиотек, отказ от тяжёлых зависимостей ради одной функции. Сторонние скрипты — аналитика, чаты, пиксели — грузите асинхронно и по возможности после взаимодействия пользователя: три виджета поддержки легко съедают секунду.
Третье — сеть и шрифты. HTTP/2 или HTTP/3, сжатие Brotli, кеширующие заголовки на статику с длинным сроком жизни и хешем в имени файла, предзагрузка критичного шрифта с font-display: swap. Всё это делается за один-два дня и обычно вытягивает Lighthouse из красной зоны. Заодно вы получаете бонус в поиске: скорость — фактор ранжирования, и на этом строится часть работ при SEO-продвижении.
Картинки — первое. Перевод в WebP или AVIF, ресайз под реальные размеры отображения, атрибуты width и height, чтобы не было скачков вёрстки, и ленивая загрузка всего, что ниже первого экрана. На каталоге мебели это единственное изменение сократило вес страницы с 6,2 до 1,4 МБ.
Скрипты — второе. Разделение бандла по маршрутам, чтобы страница входа не тянула код админки, удаление дублирующихся библиотек, отказ от тяжёлых зависимостей ради одной функции. Сторонние скрипты — аналитика, чаты, пиксели — грузите асинхронно и по возможности после взаимодействия пользователя: три виджета поддержки легко съедают секунду.
Третье — сеть и шрифты. HTTP/2 или HTTP/3, сжатие Brotli, кеширующие заголовки на статику с длинным сроком жизни и хешем в имени файла, предзагрузка критичного шрифта с font-display: swap. Всё это делается за один-два дня и обычно вытягивает Lighthouse из красной зоны. Заодно вы получаете бонус в поиске: скорость — фактор ранжирования, и на этом строится часть работ при SEO-продвижении.
Пример из практики: B2B-портал, который тормозил на каталоге
Показательный случай — портал для оптового дистрибьютора мебели. К нам пришли с жалобой: партнёры не могут работать с каталогом, страница со списком товаров открывается 7–9 секунд, а на фильтрах браузер подвисает. Заодно менеджеры жаловались на медленные отчёты по взаиморасчётам.
Замеры за два дня показали три источника проблемы. Запрос каталога собирал остатки и персональные цены партнёра прямо во время загрузки, обходя связанные таблицы в цикле — около 400 запросов на страницу. Индекса на паре «склад + товар» не было вовсе. Фронтенд получал сразу все 40 тысяч позиций и фильтровал их в браузере, потому что «так было проще на старте».
Что сделали: перенесли расчёт цен и остатков в предрассчитанную таблицу с обновлением по событиям из учётной системы, добавили составной индекс, переписали выборку на один запрос с пагинацией и серверной фильтрацией, вынесли отчёты на реплику для чтения, а картинки перегнали в WebP с ленивой загрузкой. Работа заняла около шести недель силами двух разработчиков.
Результат: каталог отдаётся за 0,6–0,9 секунды вместо 7–9, фильтры работают мгновенно, отчёты перестали мешать пользователям. Подробности проекта с ролевой моделью, бонусной системой и взаиморасчётами партнёров — в кейсе «Созвездие мебели». Такие задачи мы закрываем и в рамках разработки B2B и B2C порталов, и как отдельный проект по ускорению существующего решения.
Замеры за два дня показали три источника проблемы. Запрос каталога собирал остатки и персональные цены партнёра прямо во время загрузки, обходя связанные таблицы в цикле — около 400 запросов на страницу. Индекса на паре «склад + товар» не было вовсе. Фронтенд получал сразу все 40 тысяч позиций и фильтровал их в браузере, потому что «так было проще на старте».
Что сделали: перенесли расчёт цен и остатков в предрассчитанную таблицу с обновлением по событиям из учётной системы, добавили составной индекс, переписали выборку на один запрос с пагинацией и серверной фильтрацией, вынесли отчёты на реплику для чтения, а картинки перегнали в WebP с ленивой загрузкой. Работа заняла около шести недель силами двух разработчиков.
Результат: каталог отдаётся за 0,6–0,9 секунды вместо 7–9, фильтры работают мгновенно, отчёты перестали мешать пользователям. Подробности проекта с ролевой моделью, бонусной системой и взаиморасчётами партнёров — в кейсе «Созвездие мебели». Такие задачи мы закрываем и в рамках разработки B2B и B2C порталов, и как отдельный проект по ускорению существующего решения.
Когда оптимизировать бессмысленно и нужно переписывать
Есть ситуации, в которых точечная оптимизация превращается в перекладывание проблемы.
Первый признак — каждое ускорение одной страницы ломает две другие, потому что бизнес-логика размазана по контроллерам и триггерам базы.
Второй — вы не можете добавить второй сервер приложений, так как состояние хранится в файлах на диске.
Третий — фреймворк или версия языка сняты с поддержки, и половина библиотек не обновляется.
Здесь честный расчёт выглядит так: если стоимость поддержания текущей скорости за год превышает 50–60% стоимости переписывания проблемного модуля, дешевле переписать. Причём переписывать стоит не всё сразу, а по частям: выносите тяжёлый модуль в отдельный сервис, ставите перед ним маршрутизацию и постепенно переключаете трафик. Так вы не останавливаете бизнес на полгода.
Важный момент: переписывание без замеров повторит старые ошибки в новом стеке. Мы всегда начинаем с профилирования и фиксации целевых метрик, и только потом решаем, чинить или менять. Обсудить состояние вашего проекта можно на бесплатном аудите — напишите нам через страницу разработки веб-сервисов.
Первый признак — каждое ускорение одной страницы ломает две другие, потому что бизнес-логика размазана по контроллерам и триггерам базы.
Второй — вы не можете добавить второй сервер приложений, так как состояние хранится в файлах на диске.
Третий — фреймворк или версия языка сняты с поддержки, и половина библиотек не обновляется.
Здесь честный расчёт выглядит так: если стоимость поддержания текущей скорости за год превышает 50–60% стоимости переписывания проблемного модуля, дешевле переписать. Причём переписывать стоит не всё сразу, а по частям: выносите тяжёлый модуль в отдельный сервис, ставите перед ним маршрутизацию и постепенно переключаете трафик. Так вы не останавливаете бизнес на полгода.
Важный момент: переписывание без замеров повторит старые ошибки в новом стеке. Мы всегда начинаем с профилирования и фиксации целевых метрик, и только потом решаем, чинить или менять. Обсудить состояние вашего проекта можно на бесплатном аудите — напишите нам через страницу разработки веб-сервисов.
Как удержать результат: мониторинг и регламент
Оптимизация — не разовая акция. Через три-четыре месяца после разгона сервис снова начинает тормозить, если никто не следит за метриками: добавились новые фичи, выросли таблицы, кто-то вернул запрос в цикл. Поэтому финальная часть работ всегда включает мониторинг и правила для команды.
Минимум, который работает: APM с алертами на рост времени ответа и на появление запросов дольше секунды, дашборд с 95-м процентилем по ключевым страницам, бюджет производительности в задачах — новая функция не уходит в релиз, если страница стала медленнее на 20%. Плюс проверка планов запросов на код-ревью для всего, что касается базы.
Раз в квартал стоит проводить короткий аудит на 8–12 часов: журнал медленных запросов, отчёт Lighthouse по полевым данным, проверка размера бандла и роста таблиц. Это дешевле, чем разгребать накопившееся за год. Регламент такой поддержки мы описывали в чек-листе по обслуживанию сайта после запуска.
Минимум, который работает: APM с алертами на рост времени ответа и на появление запросов дольше секунды, дашборд с 95-м процентилем по ключевым страницам, бюджет производительности в задачах — новая функция не уходит в релиз, если страница стала медленнее на 20%. Плюс проверка планов запросов на код-ревью для всего, что касается базы.
Раз в квартал стоит проводить короткий аудит на 8–12 часов: журнал медленных запросов, отчёт Lighthouse по полевым данным, проверка размера бандла и роста таблиц. Это дешевле, чем разгребать накопившееся за год. Регламент такой поддержки мы описывали в чек-листе по обслуживанию сайта после запуска.
Частые вопросы
Сколько стоит оптимизация веб-сервиса и за какой срок видно результат?
Диагностика с замерами и планом работ занимает 2–5 дней и стоит от 40 до 80 тысяч рублей, часто мы делаем её бесплатно для проектов, которые берём в работу. Само ускорение обычно укладывается в 40–120 часов, то есть примерно от 200 до 700 тысяч рублей в зависимости от объёма кода и состояния базы. Первые результаты видны быстро: индексы и устранение проблемы N+1 дают сокращение времени ответа в два-три раза за первую же неделю. Комплексное ускорение с переработкой архитектуры отдельных модулей занимает от четырёх до восьми недель.
Поможет ли более мощный сервер, если веб-приложение тормозит?
Обычно нет или помогает ненадолго. Апгрейд железа даёт выигрыш в 20–40%, если сервис реально упирается в процессор или память, но не решает проблему, когда запрос сканирует два миллиона строк без индекса — он просто будет сканировать их чуть быстрее. Проверить легко: посмотрите загрузку CPU и диска в момент торможения. Если ресурсы свободны, а ответ идёт долго — дело в коде и базе, и переезд на сервер вдвое дороже только увеличит счёт за инфраструктуру, оставив производительность веб-приложения на том же уровне.
Как понять, что медленно именно на сервере, а не в браузере?
Откройте вкладку Network в DevTools и посмотрите на первый запрос документа или API: параметр TTFB (время до первого байта) отражает работу сервера. Если TTFB держится в пределах 200–400 мс, а страница появляется через несколько секунд — проблема на фронтенде: картинки, скрипты, шрифты, блокирующая отрисовка. Если TTFB больше секунды, чинить нужно бэкенд и базу. Полезно сравнить с полевыми данными реальных пользователей: локальные замеры на быстром интернете почти всегда оптимистичнее реальности.
Нужно ли останавливать развитие продукта на время оптимизации?
Нет, и это принципиальный момент. Мы разделяем работы на независимые блоки: индексы, кеширование, вынос тяжёлых операций в очереди, оптимизация фронтенда — каждый выкатывается отдельным релизом и откатывается при проблемах. Продуктовые задачи при этом идут своим потоком, иногда силами отдельной команды. Заморозка нужна только в редком случае замены части архитектуры, и даже тогда переключение делается постепенно, через маршрутизацию трафика между старым и новым модулем.
Диагностика с замерами и планом работ занимает 2–5 дней и стоит от 40 до 80 тысяч рублей, часто мы делаем её бесплатно для проектов, которые берём в работу. Само ускорение обычно укладывается в 40–120 часов, то есть примерно от 200 до 700 тысяч рублей в зависимости от объёма кода и состояния базы. Первые результаты видны быстро: индексы и устранение проблемы N+1 дают сокращение времени ответа в два-три раза за первую же неделю. Комплексное ускорение с переработкой архитектуры отдельных модулей занимает от четырёх до восьми недель.
Поможет ли более мощный сервер, если веб-приложение тормозит?
Обычно нет или помогает ненадолго. Апгрейд железа даёт выигрыш в 20–40%, если сервис реально упирается в процессор или память, но не решает проблему, когда запрос сканирует два миллиона строк без индекса — он просто будет сканировать их чуть быстрее. Проверить легко: посмотрите загрузку CPU и диска в момент торможения. Если ресурсы свободны, а ответ идёт долго — дело в коде и базе, и переезд на сервер вдвое дороже только увеличит счёт за инфраструктуру, оставив производительность веб-приложения на том же уровне.
Как понять, что медленно именно на сервере, а не в браузере?
Откройте вкладку Network в DevTools и посмотрите на первый запрос документа или API: параметр TTFB (время до первого байта) отражает работу сервера. Если TTFB держится в пределах 200–400 мс, а страница появляется через несколько секунд — проблема на фронтенде: картинки, скрипты, шрифты, блокирующая отрисовка. Если TTFB больше секунды, чинить нужно бэкенд и базу. Полезно сравнить с полевыми данными реальных пользователей: локальные замеры на быстром интернете почти всегда оптимистичнее реальности.
Нужно ли останавливать развитие продукта на время оптимизации?
Нет, и это принципиальный момент. Мы разделяем работы на независимые блоки: индексы, кеширование, вынос тяжёлых операций в очереди, оптимизация фронтенда — каждый выкатывается отдельным релизом и откатывается при проблемах. Продуктовые задачи при этом идут своим потоком, иногда силами отдельной команды. Заморозка нужна только в редком случае замены части архитектуры, и даже тогда переключение делается постепенно, через маршрутизацию трафика между старым и новым модулем.
С чего начать вам
Если сервис тормозит, не начинайте с покупки железа и не переписывайте фронтенд «на всякий случай». Включите журнал медленных запросов, соберите данные за сутки, постройте список страниц по формуле «частота × время ответа» и займитесь первыми тремя. В большинстве проектов этого достаточно, чтобы вернуть скорость загрузки к приемлемым значениям за одну-две недели.
Else Digital делает веб-сервисы, B2B-порталы и личные кабинеты с нагрузкой от десятков до десятков тысяч пользователей, а также берёт в работу чужой код на ускорение и поддержку. Пришлите ссылку на проект и описание проблемы — проведём замеры, покажем, где уходят секунды, и назовём честную стоимость работ до старта.
Else Digital делает веб-сервисы, B2B-порталы и личные кабинеты с нагрузкой от десятков до десятков тысяч пользователей, а также берёт в работу чужой код на ускорение и поддержку. Пришлите ссылку на проект и описание проблемы — проведём замеры, покажем, где уходят секунды, и назовём честную стоимость работ до старта.
Читать дальше
Пора обсудить
ваш проект!
ваш проект!
Оставьте заявку или напишите
